148. 排序链表
class Solution {
  struct ListRef {
    ListNode *Head;
    ListNode *Tail;
    int Length;

    ListRef() : Head(nullptr), Tail(nullptr), Length(0) {}
    ListRef(ListNode *Head, int Length) : Head(Head), Length(Length) {
      Tail = Head;
      for (int i = 0; i < Length - 1; ++i)
        Tail = Tail->next;
    }
    static ListRef makeRef(ListNode *LN) {
      int Length = 0;
      ListNode *Head = LN;
      while (LN) {
        ++Length;
        LN = LN->next;
      }
      return ListRef(Head, Length);
    }

    void append(int x) {
      if (Length == 0)
        Head = Tail = new ListNode(x);
      else {
        Tail->next = new ListNode(x);
        Tail = Tail->next;
      }
      ++Length;
    }
    void consume() {
      Head = Head->next;
      --Length;
    }
    bool remains() {
      return Length != 0;
    }
  };

  pair<ListRef, ListRef> split(ListRef L, int Midpoint) {
    ListNode *Second = L.Head;
    for (int i = 0; i < Midpoint; ++i)
      Second = Second->next;

    return {{L.Head, Midpoint}, {Second, L.Length - Midpoint}};
  };

  ListRef conquer(ListRef Left, ListRef Right) {
    ListRef Merge;
    while (Left.remains() && Right.remains()) {
      if (Left.Head->val < Right.Head->val) {
        Merge.append(Left.Head->val);
        Left.consume();
      } else {
        Merge.append(Right.Head->val);
        Right.consume();
      }
    }
    while (Left.remains()) {
      Merge.append(Left.Head->val);
      Left.consume();
    }
    while (Right.remains()) {
      Merge.append(Right.Head->val);
      Right.consume();
    }
    return Merge;
  }

  ListRef divide(ListRef L) {
    if (L.Length < 2)
      return L;

    int Mid = L.Length / 2;
    auto [Left, Right] = split(L, Mid);
    ListRef DL = divide(Left);
    ListRef DR = divide(Right);
    return conquer(DL, DR);
  }

public:
  ListNode* sortList(ListNode* head) {
    if (!head)
      return nullptr;
    return divide(ListRef::makeRef(head)).Head;
  }
};
解法最长的一集,人都写懵了,而且还是按照 \(\mathrm O(n)\) 的方法来考虑的,只能说对归并真的不太熟练。
官方题解里用双指针找中点的方法确实可以,以及 21. 合并两个有序链表 其实是之前做过的题目,所以实际上这道题是个综合题。
链表的 iterator 永远应该是节点类型的,而不是整数类型,因为节点链就是链表的原生形式。在链表当中使用整数类型作为 iterator 实际上是有问题的。
优化的解法如下所示。我觉得不用再去考虑自底向上方法了。
class Solution {
  ListNode *midpoint(ListNode *Head, ListNode *Tail) {
    ListNode *Slow = Head;
    ListNode *Fast = Head;
    while (Fast != Tail) {
      Slow = Slow->next;
      Fast = Fast->next;
      // Because we're examining for TAIL here, not null pointer, so we
      // need to be careful that the fast pointer won't pass over it.
      if (Fast != Tail)
        Fast = Fast->next;
    }
    return Slow;
  }

  ListNode *divide(ListNode *Head, ListNode *Tail) {
    // List of length 0 and 1 are considered ids.
    // Besides, the only way that head can be equal to tail is when the
    // WHOLE list has a size of 0. Thus, the head is naturally nullptr.
    if (Head == Tail)
      return nullptr;
    if (Head->next == Tail) {
      // Manually mark the list as null terminated. This feature will be
      // propagated through conquer operations.
      Head->next = nullptr;
      return Head;
    }

    ListNode *Mid = midpoint(Head, Tail);
    ListNode *Left = divide(Head, Mid);
    ListNode *Right = divide(Mid, Tail);
    return conquer(Left, Right);
  }

  ListNode *conquer(ListNode *Left, ListNode *Right) {
    ListNode Dummy;
    ListNode *L = &Dummy;
    while (Left && Right) {
      if (Left->val < Right->val) {
        L->next = Left;
        Left = Left->next;
      } else {
        L->next = Right;
        Right = Right->next;
      }
      L = L->next;
    }
    if (Left)
      L->next = Left;
    if (Right)
      L->next = Right;

    return Dummy.next;
  }

public:
  ListNode* sortList(ListNode* head) {
    // Default tail is null.
    return divide(head, nullptr);
  }
};
二刷
class Solution {
  ListNode *Merge(ListNode *Head1, ListNode *Head2) {
    ListNode Dummy;
    ListNode *Prev = &Dummy;
    while (Head1 && Head2) {
      if (Head1->val < Head2->val) {
        Prev->next = Head1;
        Head1 = Head1->next;
      } else {
        Prev->next = Head2;
        Head2 = Head2->next;
      }
      Prev = Prev->next;
    }
    if (Head1)
      Prev->next = Head1;
    if (Head2)
      Prev->next = Head2;
    return Dummy.next;
  }
  ListNode *MergeSort(ListNode *Head) {
    if (!Head)
      return {};
    if (!Head->next)
      return Head;

    ListNode Dummy(0, Head);
    ListNode *Slow = Head, *Fast = Head, *Prev = &Dummy;
    while (Fast && Fast->next) {
      Slow = Slow->next;
      Fast = Fast->next->next;
      Prev = Prev->next;
    }
    // Important! This avoids all those `Tail` checks.
    Prev->next = nullptr;

    auto Head1 = MergeSort(Head);
    auto Head2 = MergeSort(Slow);
    return Merge(Head1, Head2);
  }
public:
  ListNode* sortList(ListNode* head) {
    return MergeSort(head);
  }
};
我发现显式考虑 Tail 的方法竟然有问题?但事实上这道题完全没必要这么搞就是了,毕竟都是要把整个列表打乱重排的,就加一句 Prev->next = nullptr 能省一万个事,甚至官解的 merge() 还是要指明 tail 的,这么写就完全不用了——当然这样的话遍历就得要三个指针,有利有弊吧。
至于自底向上……我只能说,能写,但是写出来你就看吧。
class Solution {
  ListNode *Merge(ListNode *Head1, ListNode *Head2) {
    ListNode Dummy, *Prev = &Dummy;
    while (Head1 && Head2) {
      if (Head1->val < Head2->val) {
        Prev->next = Head1;
        Head1 = Head1->next;
      } else {
        Prev->next = Head2;
        Head2 = Head2->next;
      }
      Prev = Prev->next;
    }
    if (Head1)
      Prev->next = Head1;
    if (Head2)
      Prev->next = Head2;
    return Dummy.next;
  }

  int ListLength(ListNode *Head) {
    int Length = 0;
    while (Head) {
      ++Length;
      Head = Head->next;
    }
    return Length;
  }

public:
  ListNode* sortList(ListNode* head) {
    int Length = ListLength(head);
    for (int Stride = 1; Stride < Length; Stride *= 2) {
      ListNode *Head = head;
      ListNode MergeDummy(0, Head), *MergePrev = &MergeDummy;
      for (int i = 0; i < Length; i += Stride * 2) {
        // Partition.
        ListNode Dummy(0, Head);
        ListNode *MidPrev = &Dummy;
        ListNode *Mid = Head;
        for (int j = 0; j < Stride && Mid; ++j) {
          Mid = Mid->next;
          MidPrev = MidPrev->next;
        }
        ListNode *TailPrev = MidPrev;
        ListNode *Tail = Mid;
        for (int j = 0; j < Stride && Tail; ++j) {
          Tail = Tail->next;
          TailPrev = TailPrev->next;
        }
        MidPrev->next = nullptr;
        TailPrev->next = nullptr;

        // Merge.
        ListNode *NewHead = Merge(Head, Mid);

        // Reconnect.
        if (i == 0)
          head = NewHead;
        MergePrev->next = NewHead;
        ListNode NewDummy(0, NewHead), *NewPrev = &NewDummy;
        for (int j = 0; j < Stride * 2 && NewPrev->next; ++j) {
          NewPrev = NewPrev->next;
          MergePrev = NewPrev;
        }
        // XXX
        // NewPrev->next = Tail;
        Head = Tail;
      }
    }

    return head;
  }
};
这里为了处理不完整分区,在边界条件设立的两个处理需求,即 j < Stride && Mid 和 j < Stride && Tail 事实上直接否定了使用双指针的可能性,否则情况就会变得异常复杂。所以在这里,我们直接采取「Mid 先跑,Tail 再从 Mid 那里开始跑」的策略。
在分区完成、合并完成之后,对链表的重连操作也非常非常重要,因为我们的合并操作是破坏性的——我们是依靠手动把尾节点的 next 置为 nullptr 来实现的。关于重连操作,这里要着重注意几点。
首先是if (i == 0) head = NewHead; 保证每次大的合并过程之后头结点得到更新。
然后是 MergePrev->next = NewHead; 保证刚刚合并完的一小块的尾结点能够接上刚合并完的、新的这一趟的头结点。这里我其实犯了一个非常经典的错误,就是我之前是直接 NewPrev->next = Tail; 的,但是我忘记了 Tail 在下一块排序的过程当中也可能变成 NewHead 了!
最后就是 j < Stride * 2 && NewPrev->next 这个判断条件要看懂。和 Stride * 2 进行比较的原因是这里已经合并完了,这里是要对整个大块进行求尾。要求 NewPrev->next 的原因和上面对 Mid 和 Tail 进行的判断一样,为了处理可能的不完整分区,相当于是对分区的长度进行了一次取最小值操作。
总的来说,迭代方法有三层:一趟、大块、小块。在处理大块和小块的时候,尤其要注意边界条件。我觉得我的解法是我自己能记住的,所以就不写官解了。
三刷
class Solution {
  ListNode *Merge(ListNode *L1, ListNode *L2) {
    ListNode Pre, *Prev = &Pre;
    while (L1 && L2) {
      if (L1->val < L2->val) {
        Prev->next = L1;
        L1 = L1->next;
      } else {
        Prev->next = L2;
        L2 = L2->next;
      }
      Prev = Prev->next;
    }
    if (L1)
      Prev->next = L1;
    if (L2)
      Prev->next = L2;
    return Pre.next;
  }
  ListNode *MergeSort(ListNode *Head) {
    if (!Head)
      return nullptr;
    // This fixed-point is very important! If this line is omitted, we'll be in
    // a dead loop every time we get a list with only one element.
    if (!Head->next)
      return Head;

    ListNode *Fast = Head, *Slow = Head;
    ListNode SlowPre(0, Head), *SlowPrev = &SlowPre;
    while (Fast && Fast->next) {
      Fast = Fast->next->next;
      Slow = Slow->next;
      SlowPrev = SlowPrev->next;
    }
    SlowPrev->next = nullptr;

    ListNode *Left = MergeSort(Head);
    ListNode *Right = MergeSort(Slow);
    return Merge(Left, Right);
  }
public:
  ListNode* sortList(ListNode* head) {
    return MergeSort(head);
  }
};
我靠,这个递归解法里关于Head是单元素链表的不动点还挺重要的,因为如果我们不判断单元素的话,会出现下面的情况:
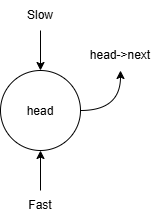
由于快指针移动的判定条件,导致Slow和Fast均指向Head,进而导致最后两个MergeSort()的调用参数是错误的,它们两个都会调用Head,违反了restrict规定,也无法触及不动点,从而使我们陷入一个单元素链表的死循环。